
Đọc bảng benchmark AI thế nào cho đúng
Ngày 28/10/2026 Google công bố Gemini 4 Carbon kèm một bảng điểm mà sau đó được chép lại khắp nơi: mười bảy phép đo, năm model, phần lớn ô thuộc về Carbon. Bảng ấy không bịa một con số nào. Nhưng nếu đọc nó như đọc bảng điểm thi, bạn sẽ hiểu sai gần hết.
Bài này không nói model nào giỏi hơn. Bài này nói cách một bảng benchmark được dựng lên, và ba chỗ mà cách dựng quyết định người thắng nhiều hơn là bản thân model.
Bảng mà ai cũng thấy
Đây là phần lõi của bảng Google công bố, giữ nguyên số:
| Phép đo | Gemini 4 Carbon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 57 | 58 |
| Terminal-Bench 4.0 | 65,2% | 59,1% | 59,6% |
| Agents' Last Exam v1.1 | 77,4% | 73,1% | 71,6% |
| OSWorld-2.1 | 81,5% | 80,9% | 87,2% |
| Vending-Bench 2 | $16.484 | $15.515 | $9.235 |
| GraphWalks | 96,2% | 71,8% | 66,8% |
Nhìn thế này thì Carbon thắng bốn trên sáu dòng. Giờ xét từng dòng một.
Chỗ thứ nhất: bảng thiếu mất người đang dẫn đầu
Dòng Terminal-Bench 4.0 ghi Carbon 65,2% và đó là số cao nhất trong bảng. Nhưng bảng xếp hạng gốc của Artificial Analysis, đúng cái mà Google trích, lại có Kimi K3.1 Pro đạt 67,2%. Kimi không có cột nào trong bảng của Google.
Chưa hết. Với Opus 5.5, Google lấy con số 59,6% do Artificial Analysis đo. Nhưng Anthropic tự chạy model của họ trên cùng phép đo ấy và công bố 66,4%. Hai con số chênh gần bảy điểm, và Google chọn con số thấp cho đối thủ trong khi dùng con số tự chạy cho mình.
Không ai gian lận ở đây. Một bên chạy bằng cấu hình của mình, một bên chạy bằng bộ giàn chuẩn hoá. Vấn đề là bảng không nói cho bạn biết điều đó.
Chỗ thứ hai: 77,4% là cột dễ
Agents' Last Exam chấm agent làm việc chuyên môn thật trên máy thật. Bảng gốc của Snorkel có hai cột: một cột tính điểm thành phần, một cột tính tỷ lệ làm xong trọn vẹn. Google trích cột thứ nhất.
| Model | Điểm thành phần | Làm xong trọn vẹn |
|---|---|---|
| GPT-6 Astra | 73,1% | 42,6% |
| Claude Opus 5.5 | 67,5% | 42,6% |
| Gemini 4 Argon | 63,8% | 37,7% |
Đọc "77,4%" người ta nghĩ ba phần tư công việc đã xong. Con số nghiêm túc của bảng ấy là 42,6%, và đó là mức cao nhất mà bất kỳ agent nào từng đạt. Thêm nữa, số Google ghi cho Argon và Opus đều cao hơn bảng gốc vài điểm, còn Carbon thì không có mặt trong bảng gốc.
Chỗ thứ ba: thứ hạng đổi khi thêm cột
Dòng Vending-Bench 2 cho model vận hành một cửa hàng suốt một năm mô phỏng. Bảng Google xếp Opus 5.5 ở $9.235, trông như hạng tư trong năm model. Bảng gốc của Andon Labs có thêm GPT-6 Sol ở $14.428 chen vào giữa, và khi tính đủ mọi model thì Opus 5.5 nằm khoảng hạng mười, dưới cả Opus 5 lẫn Sonnet 5.5.
Con số thì đúng. Thứ hạng thì sai, chỉ vì bảng chọn năm cột.
Và con số đáng chú ý nhất của phép đo này không nằm trong bảng nào cả: một người vận hành tử tế kiếm khoảng $63.000 cho cùng một năm đó. Model giỏi nhất đạt khoảng một phần tư mức ấy.
Bảy bảng, bảy quán quân
Nếu bảng của Google đáng ngờ thì bảng nào đáng tin? Câu trả lời khó chịu: tuỳ bạn hỏi bảng nào.
| Bảng xếp hạng | Đang dẫn đầu | Đo cái gì |
|---|---|---|
| AA Intelligence Index v5.0 | Gemini 4 Carbon | chỉ số gộp từ chín bài |
| LMArena — văn bản | Gemini 4 Carbon | người thật bỏ phiếu mù |
| Epoch Capabilities Index | Claude Opus 5.5 | gộp 95 benchmark, có khoảng tin cậy |
| LiveBench 2.0 | Claude Fable 5.1 | bộ đề đổi theo đợt |
| Vals Index v2.2 | Claude Sonnet 5.5 | việc thật của các ngành nghề |
| HLE-Diamond | GPT-6 Astra | nghìn câu khó nhất |
| LMArena — hình ảnh | Claude Fable 5 | không model Gemini 4 nào vào nổi top 6 |
| Terminal-Bench 4.0 | Kimi K3.1 Pro | việc chạy trong dòng lệnh |
Mỗi hãng đều có thể tự xưng số một mà không nói dối câu nào. Họ chỉ cần chọn bảng.
Thêm một chi tiết đáng nhớ: Epoch là nơi duy nhất công bố khoảng tin cậy, và khoảng tin cậy của sáu model đầu bảng chồng lên nhau hoàn toàn. Nghĩa là về mặt thống kê, sáu model ấy không phân biệt được với nhau.
Con số đáng tin hơn mọi bảng điểm
Có một nhóm phép đo khác, ít được trích hơn nhiều, vì chúng dùng việc thật và người thật chấm.
| Phép đo | Model giỏi nhất | Người |
|---|---|---|
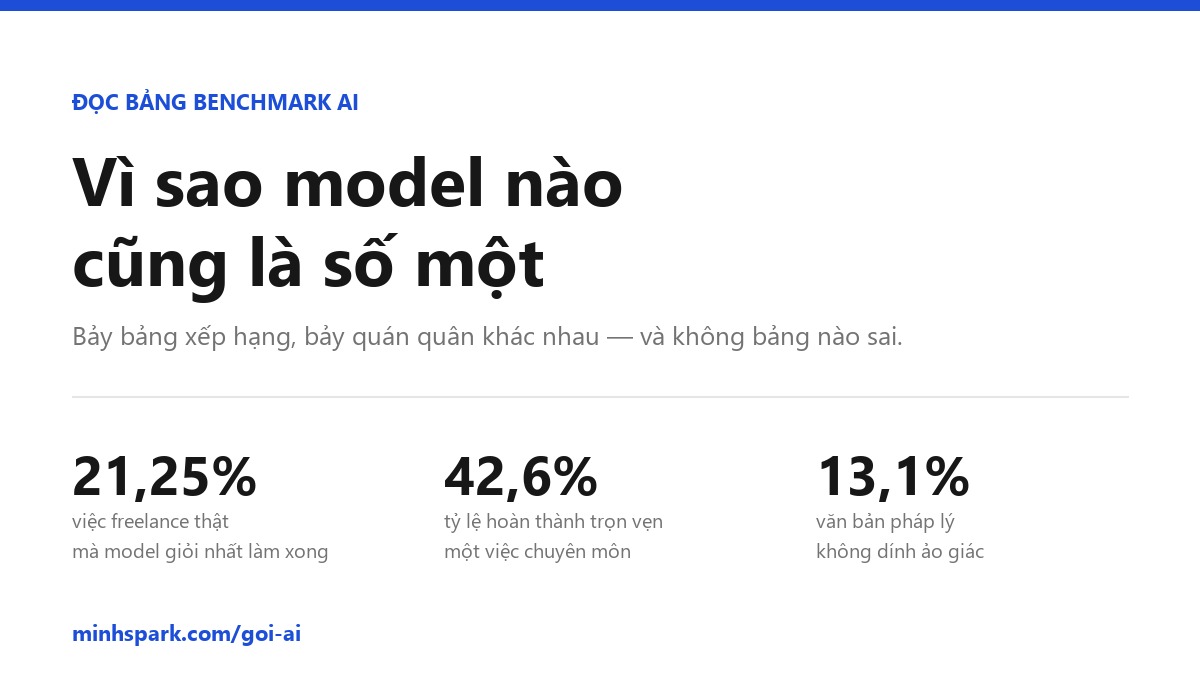
| Việc freelance có trả tiền thật | 21,25% | 100% |
| Hồ sơ nghề nghiệp so với chuyên gia | dưới 50% | 100% |
| Văn bản pháp lý không có ảo giác | 13,1% | — |
| Làm slide | 63% | 80% |
| Vận hành cửa hàng một năm | $16.484 | khoảng $63.000 |
Để đạt con số 42,6% ở phép đo chuyên môn, Claude Opus 5.5 tiêu 160 giờ 30 phút và 19,2 triệu token đầu ra cho 122 đầu việc. Đó là bức tranh thật của "AI thay người" lúc này.
Chỗ không ai đo: tiếng Việt
Đây là phần đáng nói nhất với người đọc ở Việt Nam. Không có bảng xếp hạng nào đang đo tiếng Việt cho các model đời mới.
SEA-HELM là bảng duy nhất còn xếp hạng tiếng Việt, cập nhật ngày 18/09/2026. Trong đó không có Opus 5.5, không có Gemini 4, không có GPT-6.1, không có Kimi K3, không có Grok 4.x. Năm vị trí đầu của nó chồng khoảng tin cậy lên nhau. Còn VMLU thì model đóng tốt nhất vẫn là GPT-4 của tháng 1/2024.
Trang nào khẳng định model X dịch tiếng Việt tốt nhất thì đang nói điều không ai đo được.
Vậy chọn model nào
Bỏ câu hỏi "model nào mạnh nhất" đi, hỏi "model nào làm tốt việc của tôi". Câu sau có câu trả lời, và câu trả lời thường không phải model đắt nhất.
| Công việc | Giỏi nhất | Đáng tiền nhất |
|---|---|---|
| Viết code | Claude Opus 5.5 | GPT-6.1 Sol — kém 6,6 điểm, rẻ hơn bảy lần |
| Excel, mô hình tài chính | Claude Fable 5.1 | Gemini 4 Argon — nửa giá |
| Phân tích tài chính | Claude Opus 5.5 | Gemini 4 Argon — chênh 0,2 điểm |
| Kế toán, sổ sách | Gemini 4 Argon | GLM 5.3 Flash |
| Hồ sơ văn phòng | Claude Opus 5.5 | Kimi K3.1 Pro — khoảng một phần tư giá |
| Trả lời khách hàng | Claude Fable 5 | Gemini 4 Argon |
| Review code | chưa ai đo được | — |
Một lưu ý về giá: từ Claude 4.7, cùng một đoạn văn bản sinh ra nhiều hơn khoảng 30% token so với trước. Nên so $4 một triệu token của Claude với $2 của Gemini là so sai. Thứ so được là tiền cho trọn một tác vụ.
Ba câu hỏi trước khi tin một bảng
- Số này do hãng tự chạy hay bên thứ ba đo? Hai nguồn thường lệch nhau đủ để đổi ngôi đầu.
- Bảng gốc có bao nhiêu cột, và ai bị bỏ ra ngoài?
- Cột đang trích là cột nghiêm hay cột dễ? Nhiều benchmark có cả hai.
Và câu thứ tư, dành riêng cho Gemini 4 Carbon: model dẫn đầu nhiều bảng nhất hiện chưa bán cho ai. Google phát trước cho một nhóm làm phòng thủ an ninh mạng, rồi tới đối tác. Bản mua được là Gemini 4 Argon, và nó kém khoảng một điểm ở phần lớn bảng.